เริ่มจาก Power envelope ไม่ใช่จำนวน GPU
ไฟฟ้าคือข้อจำกัดที่เปลี่ยนยากที่สุด กำหนด IT power ก่อน แล้วหักส่วนที่ไม่ใช่ Compute ออก จึงได้จำนวน Rack ที่ใส่ได้จริง
Rule · Compute racks = (IT power − Network − Storage − Mgmt) ÷ kW ต่อ Rack
ให้ Pod เท่ากับ Scalable Unit
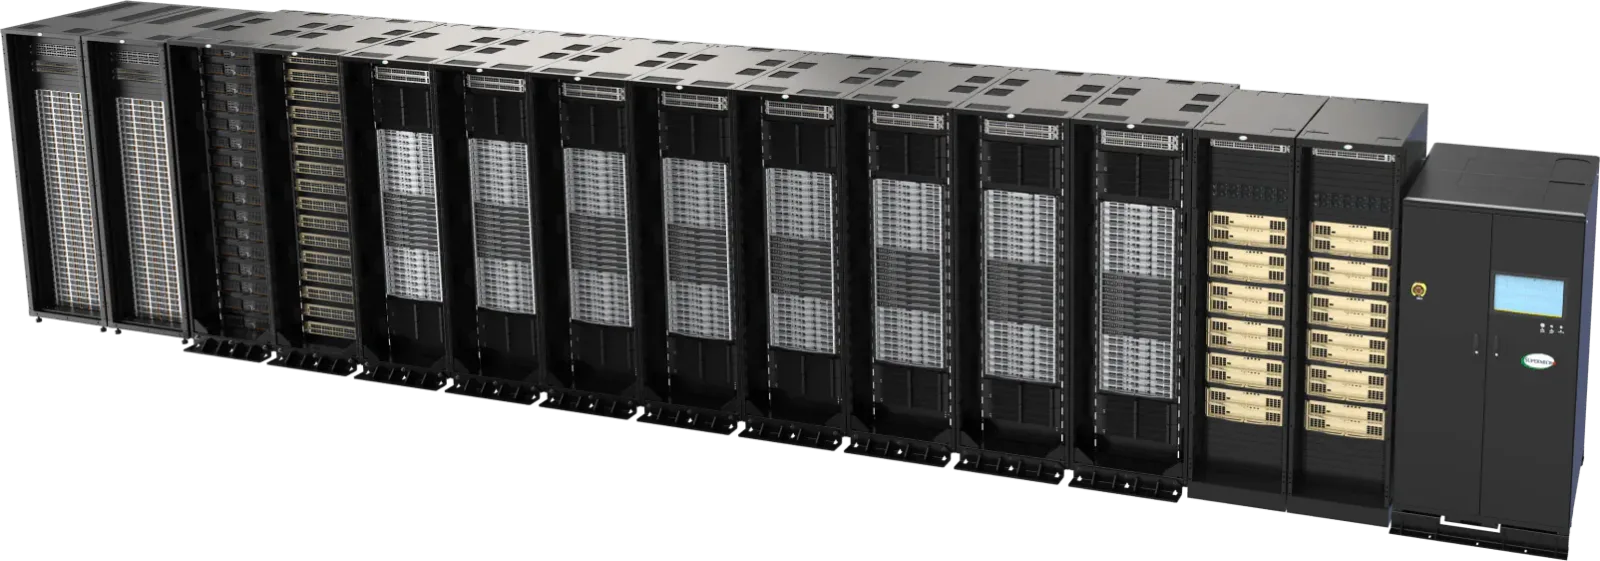
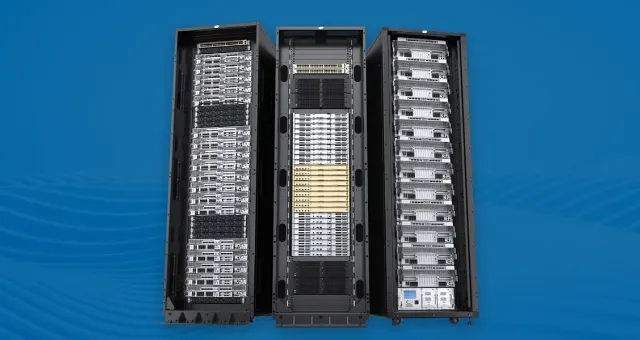
ใช้ 16 Compute Rack เป็นหน่วยเดียวกันทั้ง Cooling zone, Network pod และ Power block ทำให้เพิ่มหรือซ่อมบำรุงทีละ Unit ได้โดยไม่กระทบส่วนอื่น
Rule · Blueprint: 1 Pod = 1 SU = 16 NVL72 = 1,152 GPU · ปรับจำนวน Rack ต่อ SU ได้ตามห้องและ CDU
ออกแบบ Cooling เป็นสายต่อเนื่อง
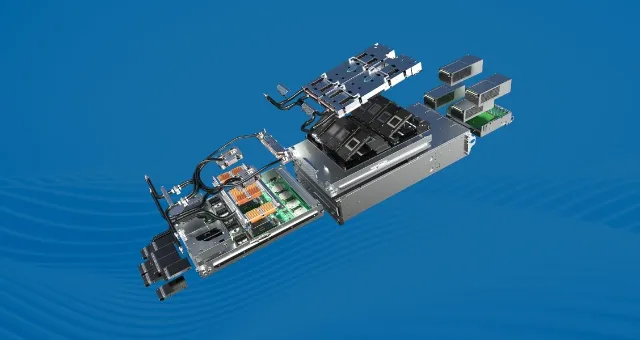
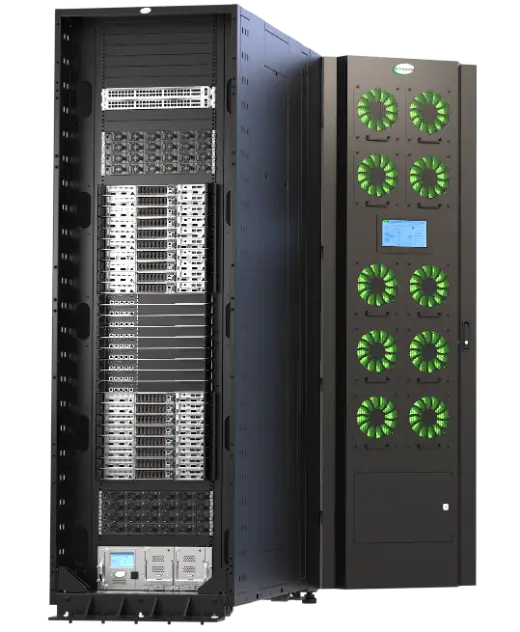
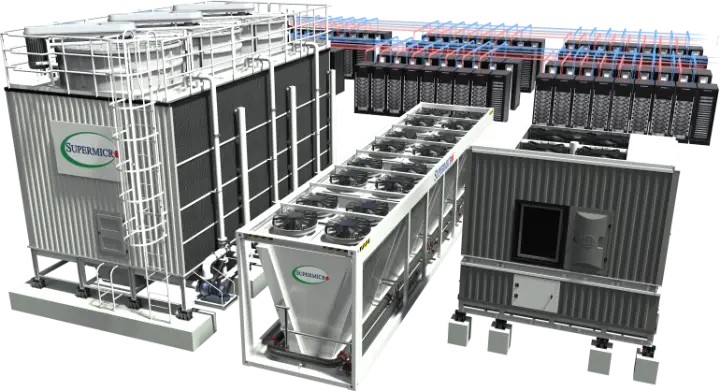
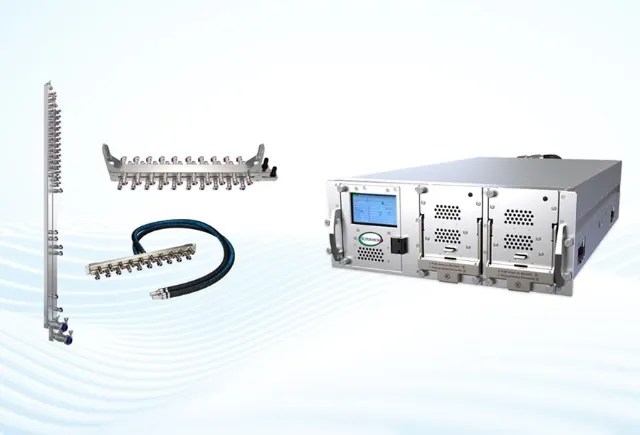
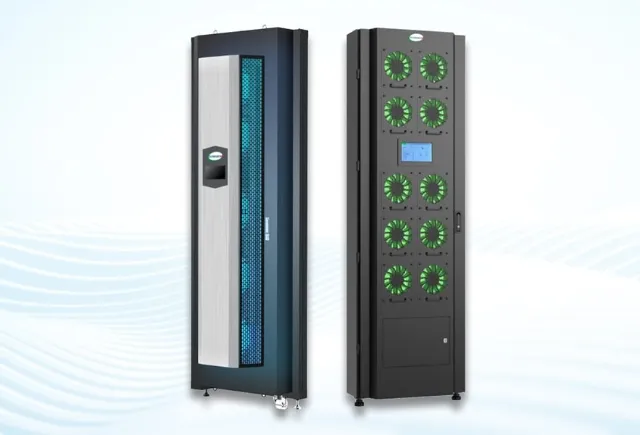
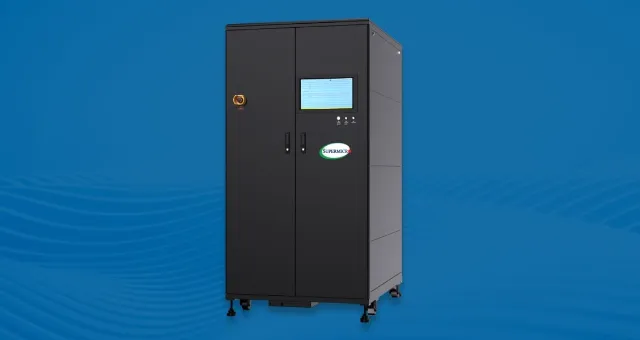
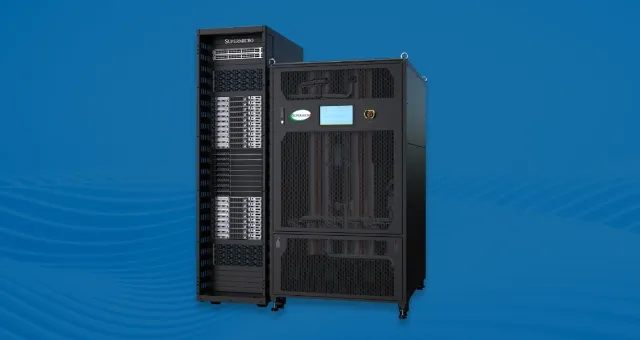
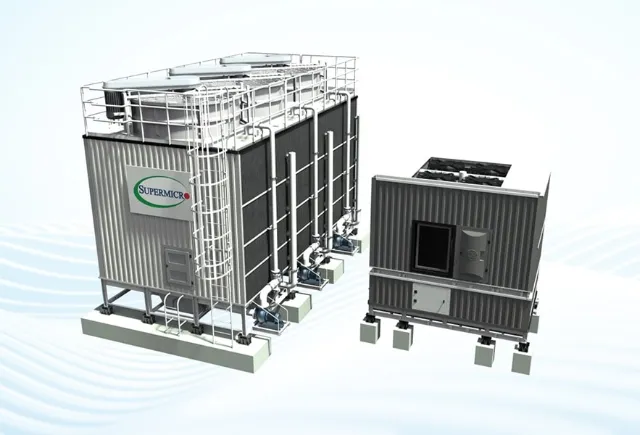
DLC-2 ดึงความร้อนที่ชิปผ่าน Cold plate, Manifold และ CDU ไปยัง Facility water แล้วระบายที่ Cooling tower หรือ Dry cooler ความร้อนที่เหลือในอากาศใช้ RDHx
Rule · In-row CDU 1.8 / 2.2 MW แบบ N+1 หรือ 5 MW ตัวเดียว (Dual redundant pumps) · ห้องไม่มีน้ำเย็นใช้ L2A Sidecar ได้เฉพาะขนาดเล็ก · Derate Cooling tower และ Dry cooler ตามอากาศจริงของไซต์
วางระบบไฟตั้งแต่ MV ถึง Power shelf
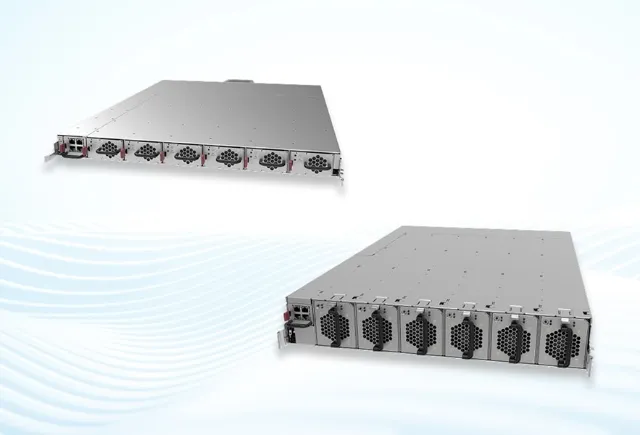
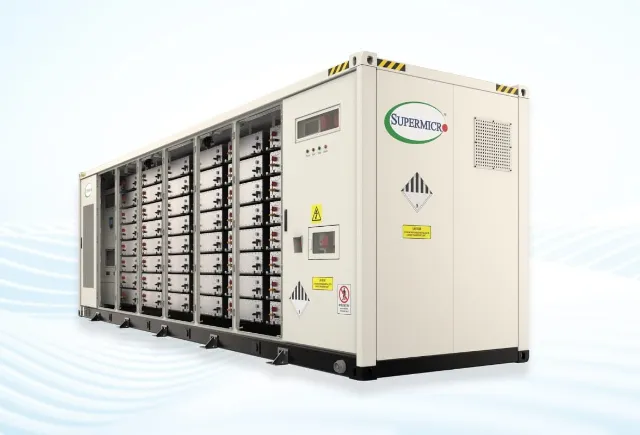
หม้อแปลง MV, LV distribution, Busbar, Power shelf 4 × 110 kW ต่อ Rack และ BBU ออกแบบ Redundancy ให้ตรงกับระดับความสำคัญของงาน
Rule · ถ้างบไฟไม่พอ Full load ทุก Rack ใช้ Power cap ต่อ Rack และยืนยัน Token/s ภายใต้ Cap · พิจารณา BESS เมื่องาน Training ยาวหลายสัปดาห์
แยก Network เป็น 4 ระนาบ
NVLink 6 ภายใน Rack (216 TB/s), Compute fabric ระหว่าง Rack ที่ 1.6 Tb/s ต่อ GPU, Converged fabric สำหรับ Storage และ North-south ผ่าน BlueField-4 และ Out-of-band management
Rule · Rail-optimized และ Non-blocking ภายใน SU ตาม NVIDIA Reference Architecture
Storage สามชั้นตาม Workload
High-performance storage สำหรับ Dataset และ Checkpoint, Context memory storage สำหรับ KV cache ของงาน Long-context และ Agentic AI, Object storage สำหรับ Data lake
Rule · Checkpoint ต้องเขียนเสร็จเร็วพอที่ GPU ไม่ต้องรอ
วางระบบบริหารตั้งแต่วันแรก
SuperCloud Composer ดูแล Server, Network, PDU และ CDU พร้อม Leak detection, Automation Center จัดการ OS, Firmware, Kubernetes และ Slurm, Director แยก Tenant ระดับ Bare metal และ Developer Console ให้บริการ GPU แบบ Self-service
Rule · กำหนด Telemetry ของ CDU, Leak detection และ Power ให้อยู่ในระบบเดียวกับ Compute
กำหนด Acceptance test ไว้ใน Scope
Rack ผ่านการทดสอบ L11 / L12 ที่โรงงาน และทดสอบซ้ำที่หน้างานทั้ง Power, Cooling, Network และ Performance ก่อนส่งมอบ
Rule · ระบุเกณฑ์ผ่าน (Burn-in, NCCL, Thermal) ใน TOR ตั้งแต่ต้น · ใช้ GPU benchmarking workflow ของ SuperCloud Automation Center ได้